Kubernetes 备份与恢复 Operator · Postgres 15–17 · PostGIS · MySQL 8.4
数据库的每一秒,都能恢复。
Keeper 将你在 Kubernetes 中运行的数据库备份到任意 S3 存储桶,并在每次变更发生时将其流式传输。选取过去几周中的任意时刻,你就能在一次性沙箱中拿回那一刻的数据库,校验已经跑完,比提一张工单还快。
- 恢复到
- 2026-10-07 09:41:27 UTC
- 基础备份
- 20261007T020712Z-4c1e
- 随后重放
- 114
$ keeper restore team/app --at 2026-10-07T09:41:27Z --wait
在窗口上拖动。琥珀色刻度是每晚的全量备份,蓝色带是它们之间的变更流。示意一个 prod 策略:每晚全量,7 天窗口。
- 9s将 644 MiB 的 Postgres 数据库恢复到沙箱:下载、解密、恢复并运行校验
- 4.2×存储桶中更小:683 MiB 的物理备份只占 161 MiB
- 72MiB/s4 vCPU 上逻辑全量备份的吞吐量,流式传输,不落临时文件
- 20ms1,000 个数据库、10 万个备份时控制台总览页的 p99
在 k3d 测试环境(4 vCPU,集群内 MinIO)中用 make test-perf 和 make test-ui 测得。数据见仓库中的 docs/PERF.md。
一分钟,从总览到恢复。
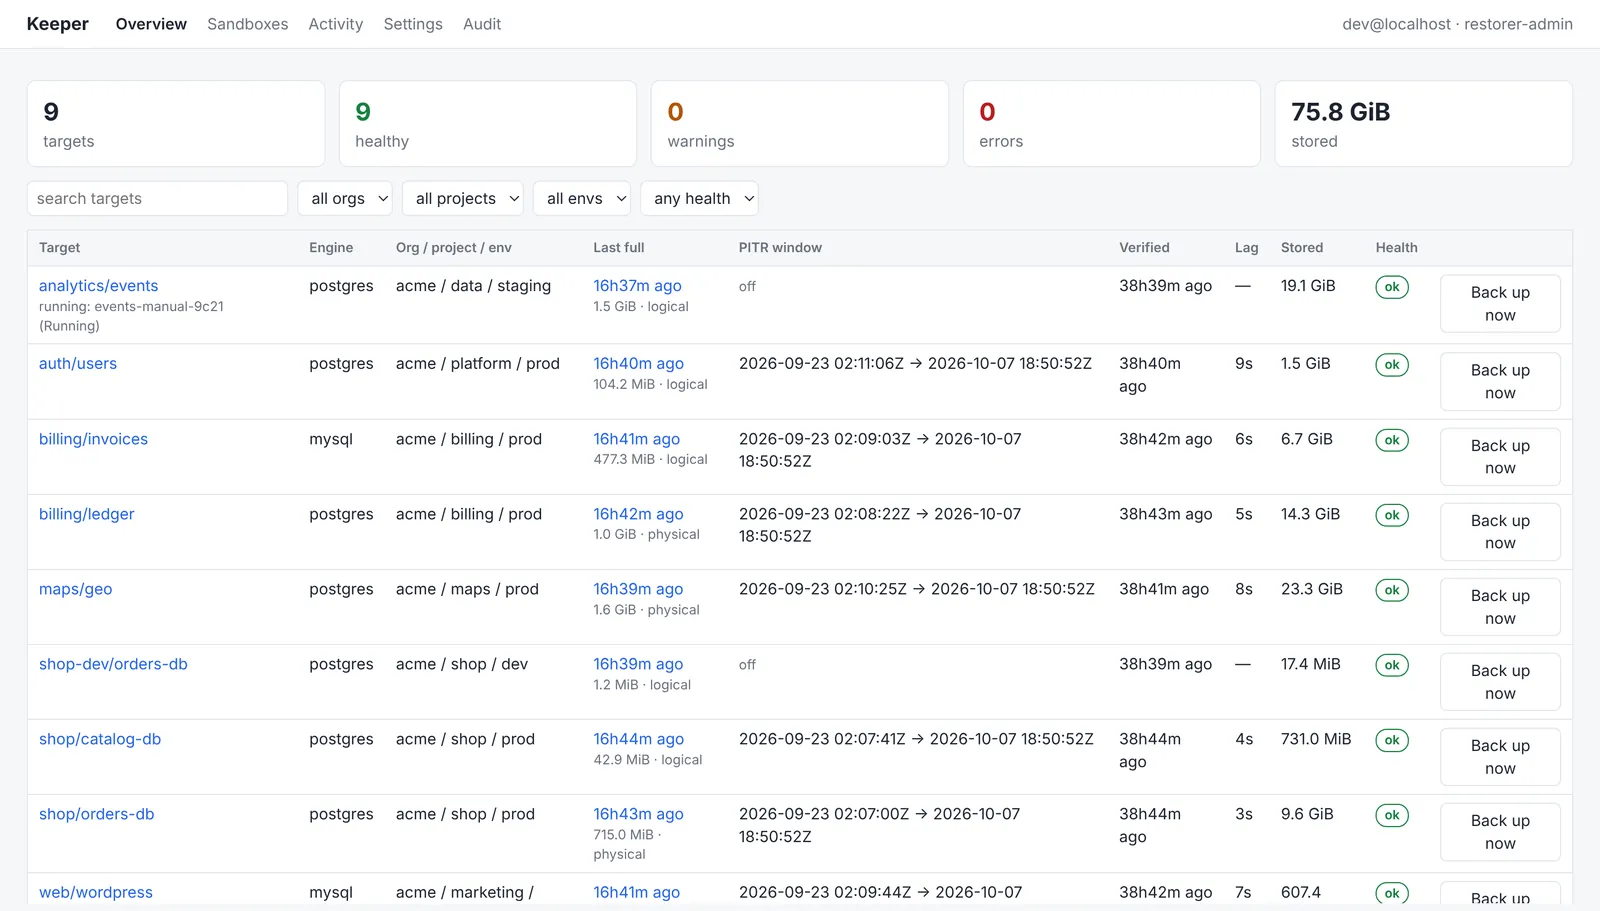
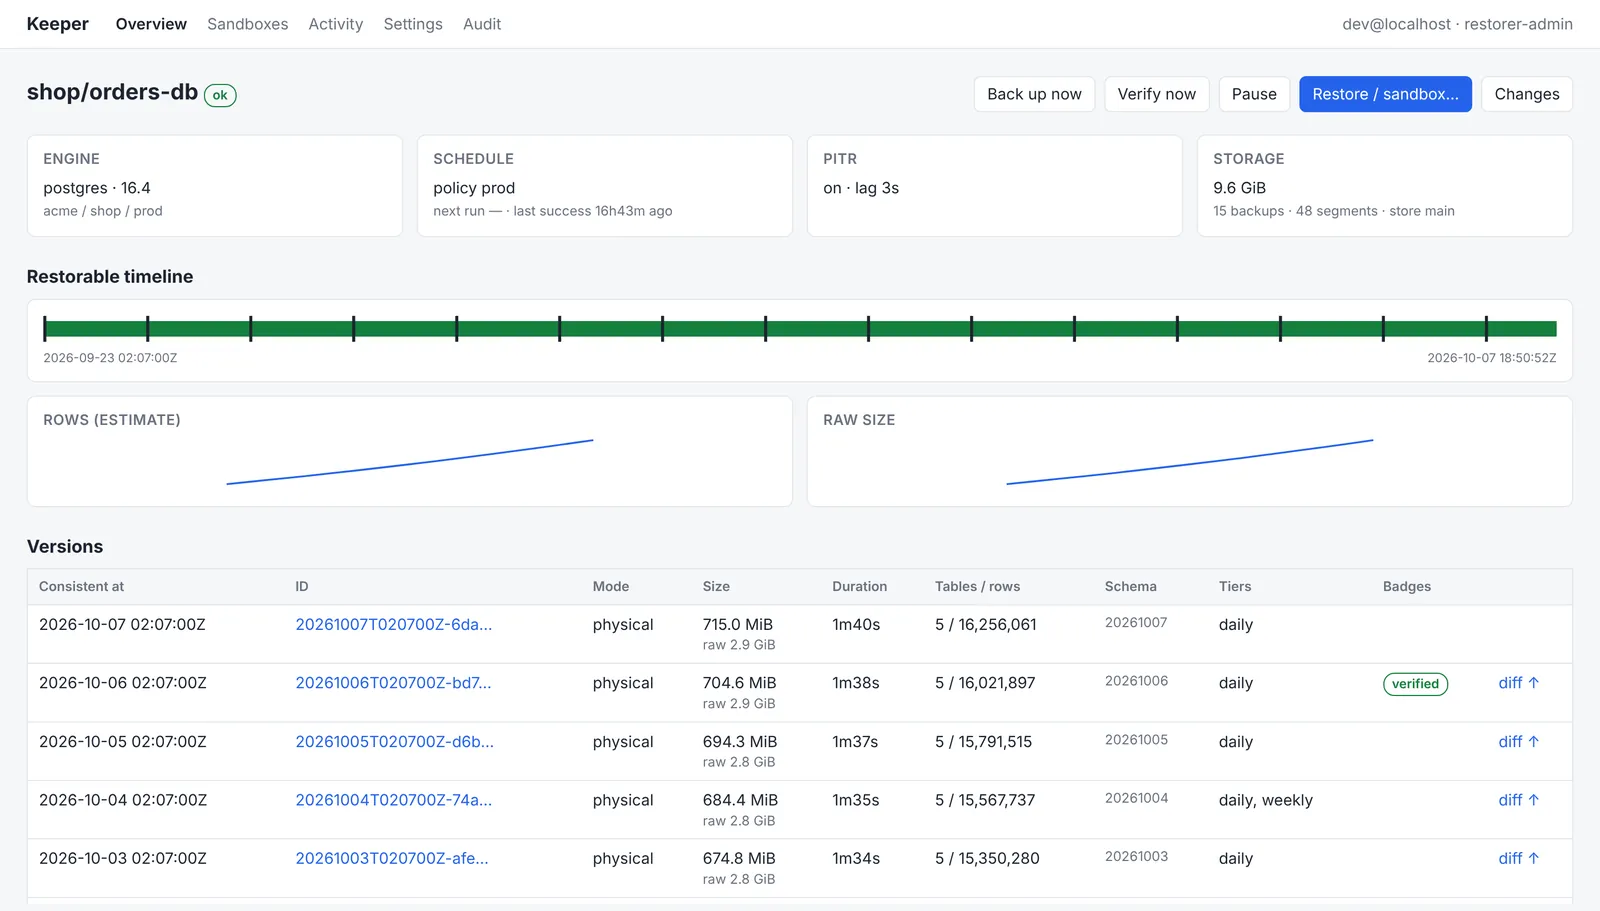
在演示数据目录上运行的真实命令和真实控制台:列出所有数据库,查看夜里改了什么,再把它恢复到沙箱。

控制台
命令行
$ keeper targets
TARGET              ENGINE    ORG/PROJECT/ENV      LAST FULL             PITR WINDOW                                  STORED    HEALTH
analytics/events    postgres  acme/data/staging    2026-10-07 02:11:47Z  -                                            19.1GiB   ok
auth/users          postgres  acme/platform/prod   2026-10-07 02:11:06Z  2026-09-23 02:11:06Z → 2026-10-07 18:50:52Z  1.5GiB    ok
billing/invoices    mysql     acme/billing/prod    2026-10-07 02:09:03Z  2026-09-23 02:09:03Z → 2026-10-07 18:50:52Z  6.7GiB    ok
billing/ledger      postgres  acme/billing/prod    2026-10-07 02:08:22Z  2026-09-23 02:08:22Z → 2026-10-07 18:50:52Z  14.3GiB   ok
maps/geo            postgres  acme/maps/prod       2026-10-07 02:10:25Z  2026-09-23 02:10:25Z → 2026-10-07 18:50:52Z  23.3GiB   ok
shop-dev/orders-db  postgres  acme/shop/dev        2026-10-07 02:12:28Z  -                                            17.4MiB   ok
shop/catalog-db     postgres  acme/shop/prod       2026-10-07 02:07:41Z  2026-09-23 02:07:41Z → 2026-10-07 18:50:52Z  731.0MiB  ok
shop/orders-db      postgres  acme/shop/prod       2026-10-07 02:07:00Z  2026-09-23 02:07:00Z → 2026-10-07 18:50:52Z  9.6GiB    ok
web/wordpress       mysql     acme/marketing/prod  2026-10-07 02:09:44Z  2026-09-23 02:09:44Z → 2026-10-07 18:50:52Z  607.4MiB  ok
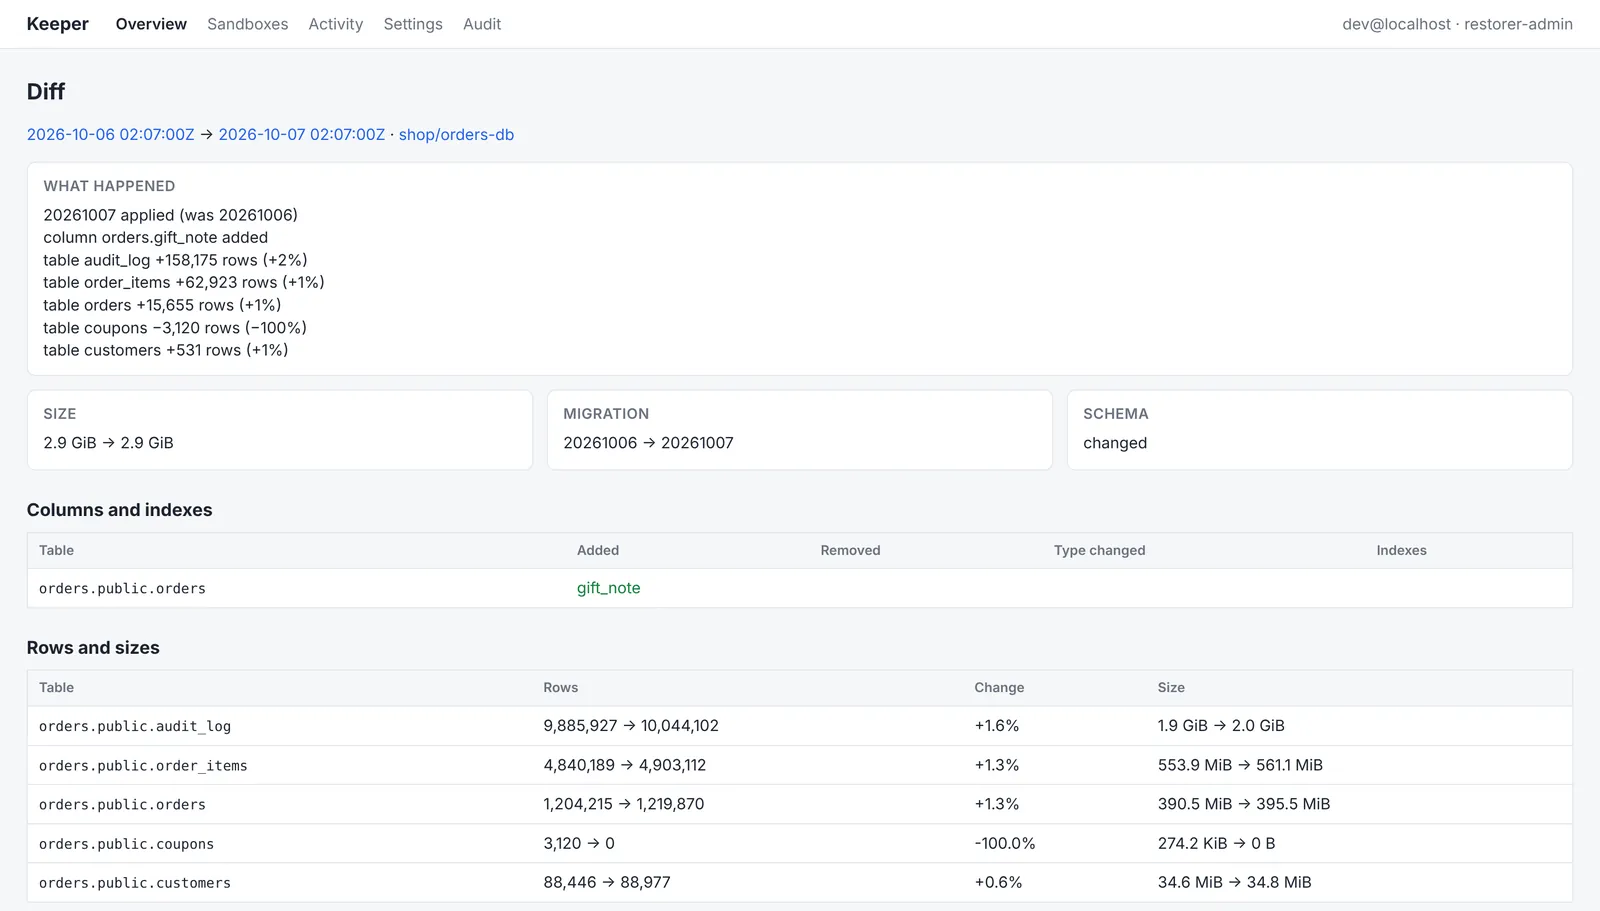
$ keeper diff 20261006T020700Z-bd79 20261007T020700Z-6da5
from  20261006T020700Z-bd79 (2026-10-06 02:07:00Z)
to    20261007T020700Z-6da5 (2026-10-07 02:07:00Z)

20261007 applied (was 20261006)
column orders.gift_note added
table audit_log +158,175 rows (+2%)
table order_items +62,923 rows (+1%)
table orders +15,655 rows (+1%)
table coupons −3,120 rows (−100%)
table customers +531 rows (+1%)

14 segments in between:
  00000001000000A100000000  18:51:32–19:20:32 · 800 commits · audit_log +3348 / ~1116 / −83 · order_items +1327 / ~442 / −33 · orders +330 / ~110 / −8 · customers +11 / ~3 / −0
  00000001000000A100000001  19:21:32–19:50:32 · 813 commits · audit_log +3352 / ~1116 / −83 · order_items +1328 / ~442 / −33 · orders +330 / ~110 / −8 · customers +13 / ~3 / −0
  00000001000000A100000002  19:51:32–20:20:32 · 826 commits · audit_log +3356 / ~1116 / −83 · order_items +1329 / ~442 / −33 · orders +330 / ~110 / −8 · customers +15 / ~3 / −0
$ keeper restore shop/orders-db --at 20261006T020700Z-bd79 --ttl 6h --reason "coupons truncated"
restore orders-db-sandbox-60414a15fc created (sandbox from 20261006T020700Z-bd79, 0 segments)
restore  shop/orders-db-sandbox-60414a15fc

$ keeper sandbox list
NAME      ENGINE    SOURCE            OWNER               PHASE         EXPIRES               IN-CLUSTER
sbx-7f3a  postgres  shop/orders-db    maria@acme.example  Ready         2026-10-08 00:37:32Z  keeper-sbx-sbx-7f3a.keeper-sandboxes.svc:5432
sbx-c210  mysql     billing/invoices  dev@acme.example    Provisioning  -
来自仓库中演示服务器的输出:运行 go run ./hack/demo,再把命令行或浏览器指向它。
恢复到任何地方,不碰生产环境。
一次恢复就是一个普通的 Kubernetes 资源。指定时间或备份 ID,选好目标。Keeper 规划基础备份和要重放的变更,并在判定成功前运行你的校验。
一次性副本
带 TTL、凭据和只读查询控制台的私有数据库,到期自动清理。
--to sandbox --ttl 6h新数据库
先在中转沙箱中恢复并校验,再以新名称复制。绝不覆盖已有对象。
--to new --database app_copy真正回滚
先做一次安全备份,并要求你输入目标名称确认。需要 restorer-admin 角色。
--to in-place --confirm app导出文件
解密并压缩的逻辑导出,通过一小时后失效的链接提供。全程审计。
--to download轻到你会忘了它的存在。
Keeper 是一个 Go 二进制文件。控制器和 API 只负责调度和读取;数据在完成后即退出的短生命周期 Job 中搬运,两次备份之间集群里不会留下任何重负载。
k3d 测试集群(12 个数据库)在端到端和混沌测试之后由 kubelet 报告的工作集;空闲 CPU 只有几毫核。每个启用时间点恢复的数据库还会运行一个 streamer,流式传输时约占 70 MiB。
天生就快
无临时文件的流式管道、并行分片上传、多线程 zstd,以及支撑毫秒级响应控制台的内存数据目录。
天生可靠
仅崩溃(crash-only)设计:任何 Pod 随时可能退出。状态保存在 CRD 和 S3 中,备份只有在清单最后写入后才算存在,没有任何操作会无限等待。
清楚两个版本之间改了什么。
每个备份都带有表、行数和大小的清单,每个变更段都带有它所做操作的摘要。所以在恢复之前,你就能看到哪个版本还保留着丢失的行。
- 任意两个备份之间的差异。 表结构变化、行数和每张表的大小。
- 每个 WAL 或 binlog 段的变更摘要。 每张表的插入、更新、删除和 DDL,22:48 的一次 TRUNCATE 一眼就能找到。
- 脱敏预览。 按你指定的列脱敏的示例行,用无法解密数据本身的目录密钥即可读取。
为出事的那个夜晚而生。
变更流
Postgres 使用复制槽上的 Keeper 自研 WAL 接收器,MySQL 使用 mysqlbinlog。即使数据库很安静,窗口也能延伸到现在。
经过验证,而非寄望
定时校验恢复会在真实恢复上运行你的 SQL 检查,并把备份标记为已校验。恢复耗时以指标形式导出。
离开前就已加密
每个对象都在客户端用 age 加密到你的密钥。存储桶永远看不到明文,控制台的目录密钥也读不了数据。
默认压缩
按策略选择 zstd 级别,在管道中只压缩一次。导出工具不做压缩,数据库服务器也不为此消耗 CPU。
绝不卡死
不挂载、不用块设备,只通过网络访问数据库。每条数据流都有进度看门狗,每个工具都运行在独立的进程组中。
仅崩溃设计
随时杀掉任何 Pod 都没关系。备份只有在清单最后写入后才算存在,混沌测试会在备份中途杀掉 Keeper 来证明这一点。
对生产温和
最小权限的只读用户。按主机分配槽位、限制带宽,服务器繁忙时由负载保护推迟备份。
控制台、命令行和 API
一个用 OpenAPI 描述的 JSON API,角色来自 Cloudflare Access。每次写入和每次查询都会被审计。
原生 GitOps
存储、策略、目标和恢复都是 CRD。保留层级、告警和 Grafana 仪表盘随 Chart 一起提供。
数据在 Job 中流动,从不经过控制器。
控制器只负责调度。mover 和 streamer 通过一条流式管道把字节直接送进你的存储桶,restorer 再把它们取回。
远不止存储桶里的一份夜间导出。
| 当你需要…… | cron + pg_dump 脚本 | Keeper |
|---|---|---|
| 回到 09:41:27 | 昨晚的导出,最多丢失 24 小时 | 窗口内的任意一秒 |
| 证明备份能恢复 | 在故障中才发现 | 带你的检查的定时校验恢复 |
| 找到还有丢失行的版本 | 恢复好几个逐个查看 | 控制台中的差异和变更摘要 |
| 无风险地查看 | 覆盖到共享的预发环境 | 带 TTL 的私有沙箱 |
| 让存储桶看不到内容 | 服务端加密(如果配置了) | 用你的密钥做客户端 age 加密 |
| 扛住备份中途的节点故障 | 一个看似完整的半截文件 | 清单最后写入之前一切都不算数 |
| 确认它仍在工作 | 毫无动静 | 针对备份逾期、链断裂和延迟的告警 |
从零到可恢复。
安装 Chart
CRD、控制器、API 与控制台、RBAC、告警和仪表盘。
helm install keeper charts/keeper -n keeper-system --create-namespace \
  --set image.repository=registry.example.com/keeper/keeper --set image.tag=v0.1.0 \
  --set 'targetNamespaces={team-a}'
指定存储桶和你的密钥
任何兼容 S3 的存储。用 age-keygen 生成 age 密钥,并离线保存一份副本。
apiVersion: keeper.republic.global/v1alpha1
kind: BackupStore
metadata: { name: main }
spec:
  s3:
    endpoint: https://s3.example.com
    region: us-east-1
    bucket: db-backups
    credentialsSecret: { namespace: keeper-system, name: keeper-s3 }
  encryption:
    ageRecipients: [age1…]   # 只放公钥;私钥离线保存
在数据库旁声明一个目标
用 docs/sql/ 中的 SQL 创建只读用户,再把目标提交到 git。
apiVersion: keeper.republic.global/v1alpha1
kind: BackupTarget
metadata: { name: app, namespace: team-a }
spec:
  engine: postgres
  endpoint: { host: postgres, port: 5432 }
  databases: [app]
  policy: prod             # 每晚全量,7 天时间点窗口
  credentials:
    secretRef: { name: keeper-backup-postgres }
    replicationSecretRef: { name: keeper-repl-postgres }
特意恢复一次
第一次全量备份会自动开始。然后试试那个你希望永远用不上的操作。
keeper targets
keeper restore team-a/app --at 2026-10-07T09:41:27Z --wait
keeper query <sandbox> -e "select count(*) from orders"
完整指南、每个 CRD 字段和 REST API 都在文档中(英文)。