Opérateur de sauvegarde et restauration pour Kubernetes · Postgres 15–17 · PostGIS · MySQL 8.4
Chaque seconde de votre base de données, restaurable.
Keeper sauvegarde les bases de données que vous exécutez sur Kubernetes vers n'importe quel bucket S3 et diffuse chaque modification dès qu'elle se produit. Choisissez un instant des dernières semaines et vous récupérez exactement cette base dans un bac à sable jetable, vérifications déjà faites, en moins de temps qu'il n'en faut pour ouvrir un ticket.
- Restaurer à
- 2026-10-07 09:41:27 UTC
- Sauvegarde de base
- 20261007T020712Z-4c1e
- Puis rejouer
- 114
$ keeper restore team/app --at 2026-10-07T09:41:27Z --wait
Faites glisser sur la fenêtre. Les repères ambre sont les sauvegardes complètes nocturnes ; la bande bleue est le flux de modifications entre elles. Illustration d'une politique prod : complète chaque nuit, fenêtre de 7 jours.
- 9spour restaurer une base Postgres de 644 Mio dans un bac à sable : téléchargement, déchiffrement, récupération et vérifications
- 4.2×plus petit dans le bucket : une sauvegarde physique de 683 Mio stockée en 161 Mio
- 72MiB/sde débit pour une sauvegarde logique complète sur 4 vCPU, en flux, sans fichier temporaire
- 20msp99 de la vue d'ensemble de la console avec 1 000 bases et 100 000 sauvegardes
Mesuré avec make test-perf et make test-ui sur l'environnement de test k3d (4 vCPU, MinIO dans le cluster). Les chiffres sont dans docs/PERF.md du dépôt.
Une minute, du début à la restauration.
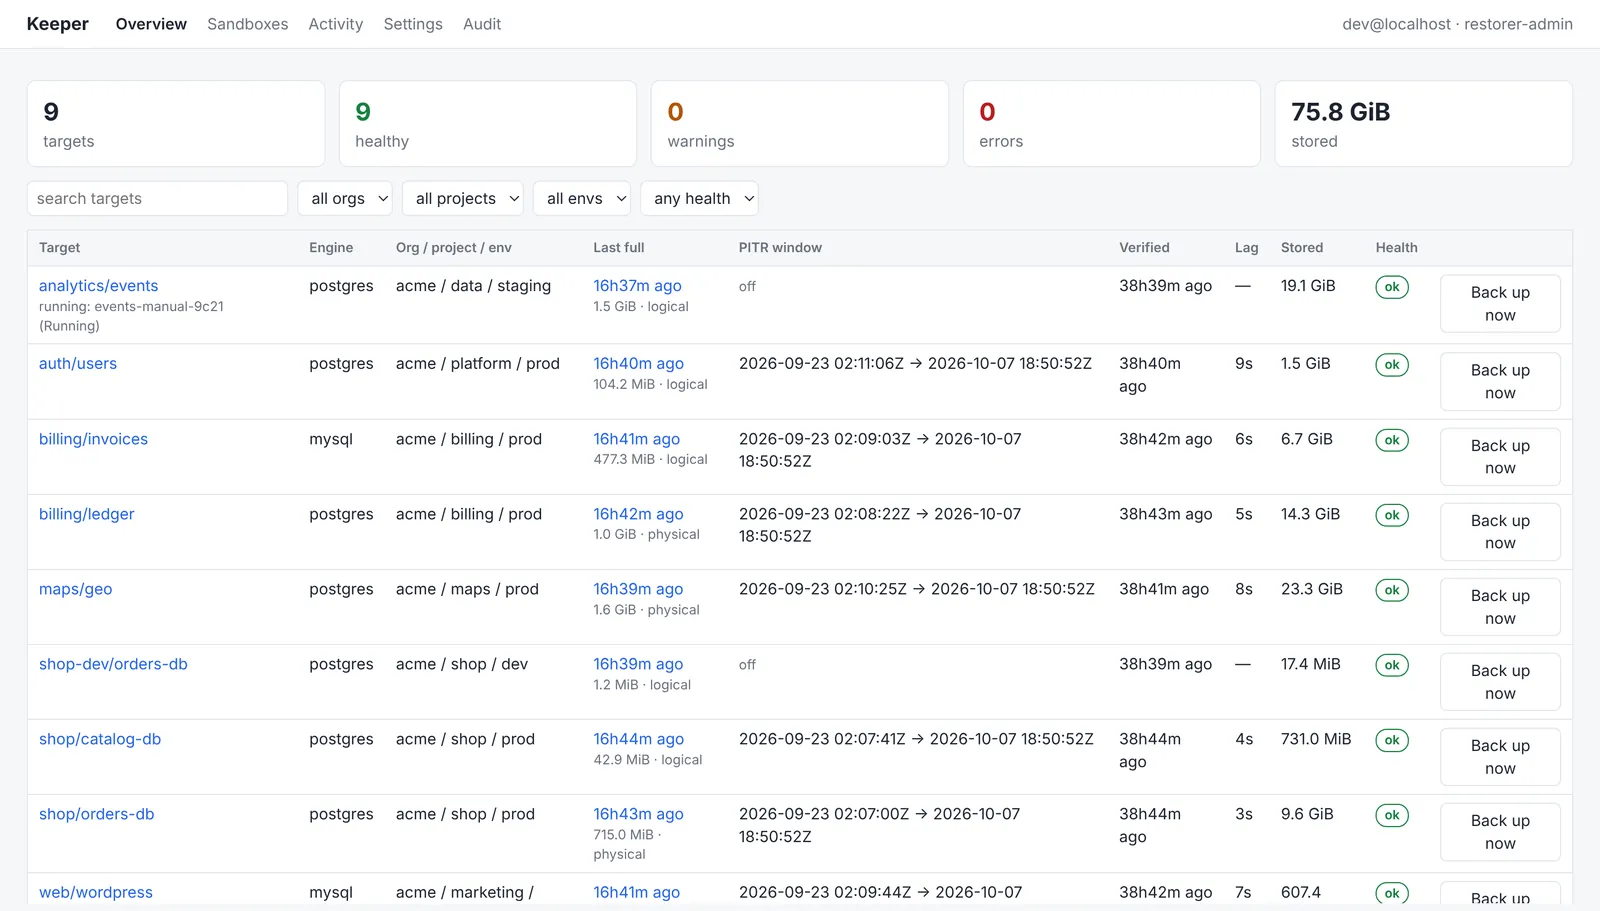
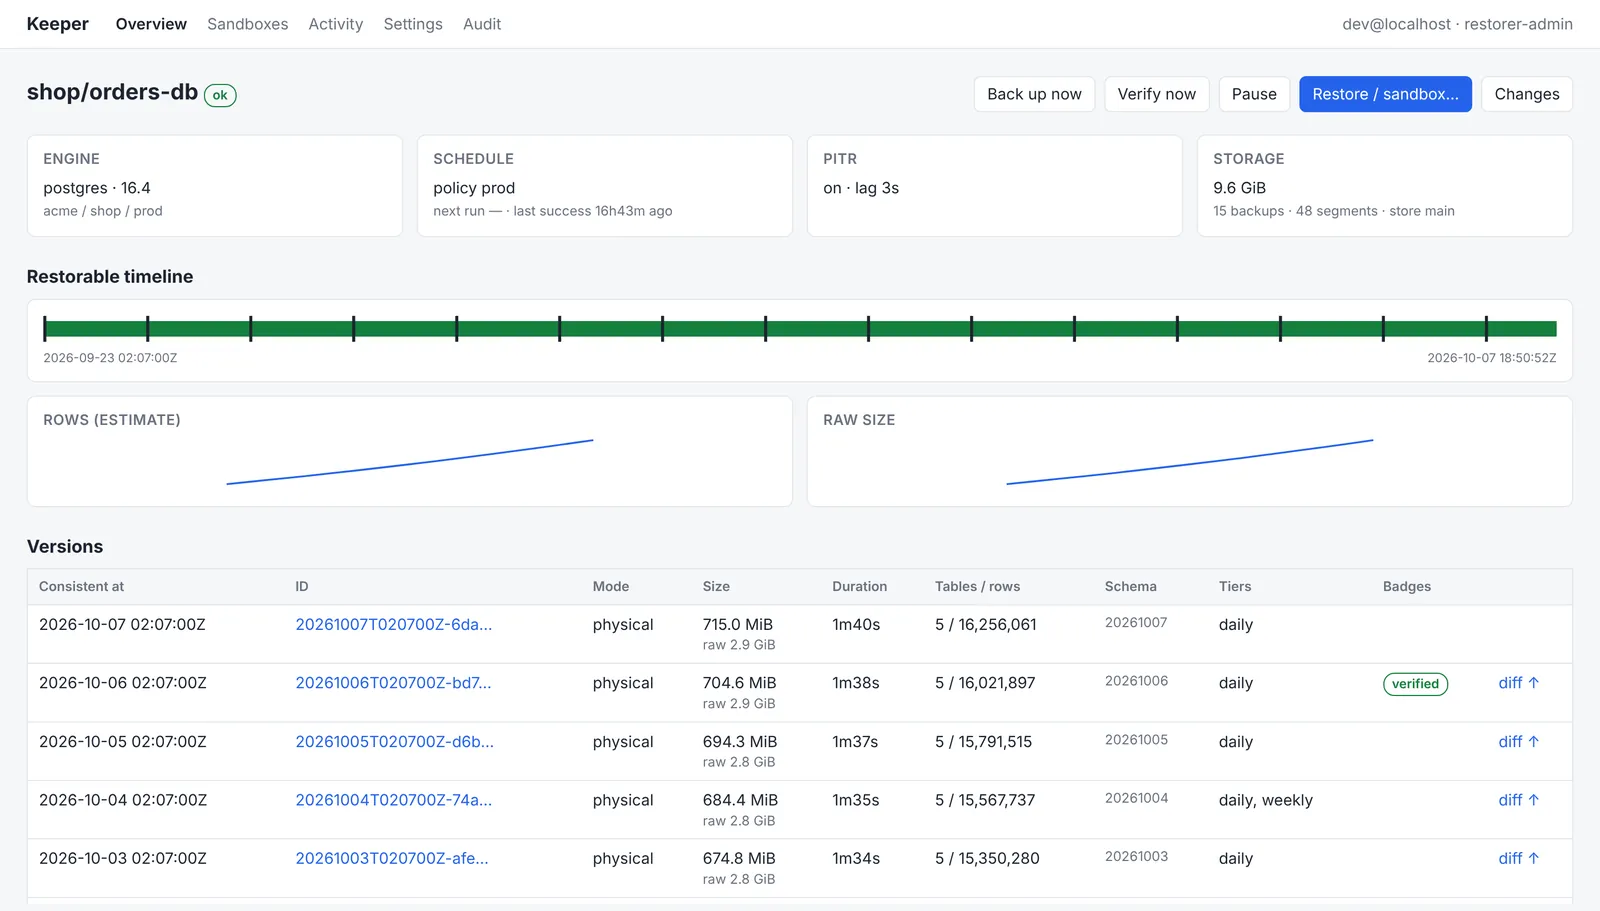
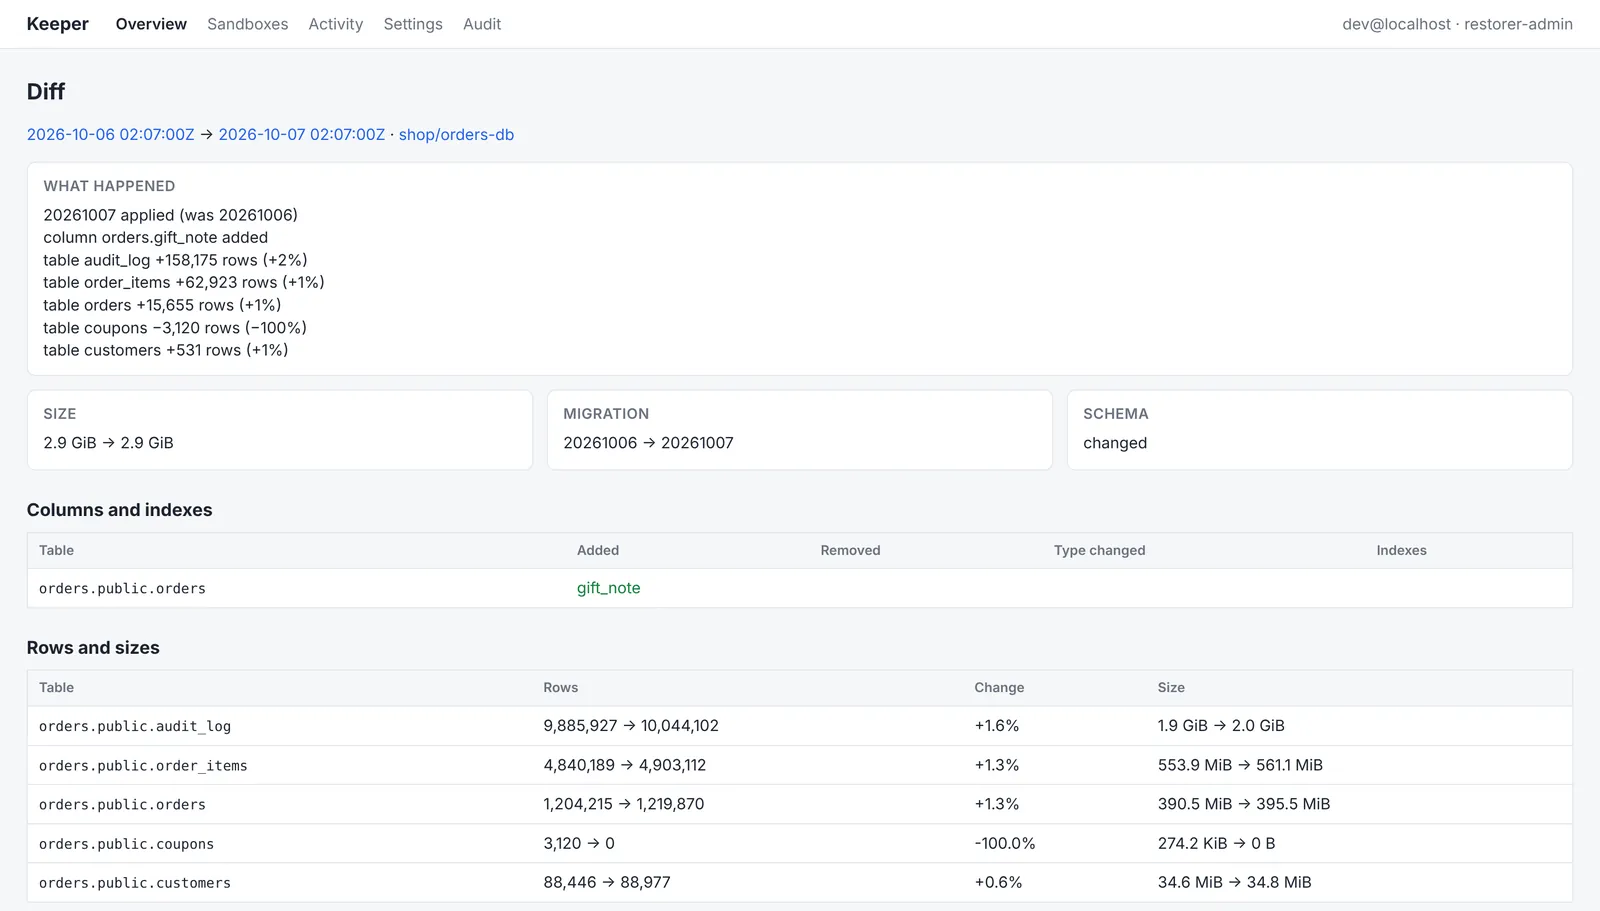
De vraies commandes et la vraie console sur un catalogue de démonstration : listez chaque base, voyez ce qui a changé pendant la nuit, restaurez-la dans un bac à sable.

La console
La CLI
$ keeper targets
TARGET              ENGINE    ORG/PROJECT/ENV      LAST FULL             PITR WINDOW                                  STORED    HEALTH
analytics/events    postgres  acme/data/staging    2026-10-07 02:11:47Z  -                                            19.1GiB   ok
auth/users          postgres  acme/platform/prod   2026-10-07 02:11:06Z  2026-09-23 02:11:06Z → 2026-10-07 18:50:52Z  1.5GiB    ok
billing/invoices    mysql     acme/billing/prod    2026-10-07 02:09:03Z  2026-09-23 02:09:03Z → 2026-10-07 18:50:52Z  6.7GiB    ok
billing/ledger      postgres  acme/billing/prod    2026-10-07 02:08:22Z  2026-09-23 02:08:22Z → 2026-10-07 18:50:52Z  14.3GiB   ok
maps/geo            postgres  acme/maps/prod       2026-10-07 02:10:25Z  2026-09-23 02:10:25Z → 2026-10-07 18:50:52Z  23.3GiB   ok
shop-dev/orders-db  postgres  acme/shop/dev        2026-10-07 02:12:28Z  -                                            17.4MiB   ok
shop/catalog-db     postgres  acme/shop/prod       2026-10-07 02:07:41Z  2026-09-23 02:07:41Z → 2026-10-07 18:50:52Z  731.0MiB  ok
shop/orders-db      postgres  acme/shop/prod       2026-10-07 02:07:00Z  2026-09-23 02:07:00Z → 2026-10-07 18:50:52Z  9.6GiB    ok
web/wordpress       mysql     acme/marketing/prod  2026-10-07 02:09:44Z  2026-09-23 02:09:44Z → 2026-10-07 18:50:52Z  607.4MiB  ok
$ keeper diff 20261006T020700Z-bd79 20261007T020700Z-6da5
from  20261006T020700Z-bd79 (2026-10-06 02:07:00Z)
to    20261007T020700Z-6da5 (2026-10-07 02:07:00Z)

20261007 applied (was 20261006)
column orders.gift_note added
table audit_log +158,175 rows (+2%)
table order_items +62,923 rows (+1%)
table orders +15,655 rows (+1%)
table coupons −3,120 rows (−100%)
table customers +531 rows (+1%)

14 segments in between:
  00000001000000A100000000  18:51:32–19:20:32 · 800 commits · audit_log +3348 / ~1116 / −83 · order_items +1327 / ~442 / −33 · orders +330 / ~110 / −8 · customers +11 / ~3 / −0
  00000001000000A100000001  19:21:32–19:50:32 · 813 commits · audit_log +3352 / ~1116 / −83 · order_items +1328 / ~442 / −33 · orders +330 / ~110 / −8 · customers +13 / ~3 / −0
  00000001000000A100000002  19:51:32–20:20:32 · 826 commits · audit_log +3356 / ~1116 / −83 · order_items +1329 / ~442 / −33 · orders +330 / ~110 / −8 · customers +15 / ~3 / −0
$ keeper restore shop/orders-db --at 20261006T020700Z-bd79 --ttl 6h --reason "coupons truncated"
restore orders-db-sandbox-60414a15fc created (sandbox from 20261006T020700Z-bd79, 0 segments)
restore  shop/orders-db-sandbox-60414a15fc

$ keeper sandbox list
NAME      ENGINE    SOURCE            OWNER               PHASE         EXPIRES               IN-CLUSTER
sbx-7f3a  postgres  shop/orders-db    maria@acme.example  Ready         2026-10-08 00:37:32Z  keeper-sbx-sbx-7f3a.keeper-sandboxes.svc:5432
sbx-c210  mysql     billing/invoices  dev@acme.example    Provisioning  -
Sortie du serveur de démonstration du dépôt : go run ./hack/demo, puis pointez la CLI ou un navigateur dessus.
Restaurez n'importe où, sans toucher à la production.
Une restauration est une ressource Kubernetes comme une autre. Demandez un instant ou un identifiant de sauvegarde et choisissez la destination. Keeper planifie la sauvegarde de base et les modifications à rejouer, puis exécute vos vérifications avant de déclarer la restauration réussie.
Une copie jetable
Une base privée avec TTL, identifiants et console de requêtes en lecture seule. Elle se nettoie toute seule.
--to sandbox --ttl 6hUne nouvelle base
Restaurée et vérifiée dans un bac à sable intermédiaire, puis copiée sous un nouveau nom. Les objets existants ne sont jamais écrasés.
--to new --database app_copyRevenir en arrière pour de vrai
Fait d'abord une sauvegarde de sécurité et vous demande de taper le nom de la cible. Nécessite le rôle restorer-admin.
--to in-place --confirm appUn fichier de dump
Un dump logique déchiffré et compressé, derrière un lien qui expire au bout d'une heure. Audité.
--to downloadAssez léger pour qu'on l'oublie.
Keeper est un unique binaire Go. Le contrôleur et l'API ne font que planifier et lire ; les données transitent par des Jobs de courte durée qui s'arrêtent une fois terminés, donc rien de lourd ne reste dans votre cluster entre deux sauvegardes.
Working set rapporté par le kubelet dans le cluster de test k3d (12 bases) après les suites de bout en bout et de chaos ; le CPU au repos se compte en quelques millicœurs. Chaque base avec restauration à un instant fait aussi tourner un streamer, environ 70 Mio pendant qu'il diffuse.
Rapide par construction
Pipelines en flux sans fichier temporaire, envois multipart en parallèle, zstd multithread et un catalogue en mémoire derrière une console qui répond en millisecondes.
Fiable par construction
Conception crash-only : n'importe quel pod peut tomber à tout moment. L'état vit dans les CRD et S3, une sauvegarde n'existe qu'une fois son manifeste écrit en dernier, et rien n'attend indéfiniment.
Sachez ce qui a changé entre deux versions.
Chaque sauvegarde porte un inventaire de ses tables, lignes et tailles. Chaque segment de modifications porte un résumé de ce qu'il a fait. Avant de restaurer quoi que ce soit, vous voyez quelle version contenait encore les lignes perdues.
- Diffs entre deux sauvegardes quelconques. Changements de schéma, nombre de lignes et taille par table.
- Résumés de modifications par segment WAL ou binlog. Insertions, mises à jour, suppressions et DDL par table : un TRUNCATE à 22:48 se retrouve facilement.
- Aperçus masqués. Des lignes d'exemple avec les colonnes que vous indiquez masquées, lisibles avec une clé de catalogue qui ne peut pas déchiffrer les données.
Conçu pour la nuit où tout dérape.
Flux de modifications
Le récepteur WAL de Keeper sur un slot de réplication pour Postgres, et mysqlbinlog pour MySQL. La fenêtre atteint le présent, même sur une base inactive.
Vérifié, pas espéré
Des restaurations de vérification planifiées exécutent vos requêtes SQL sur une vraie restauration et marquent la sauvegarde vérifiée. Leur durée est exportée en métrique.
Chiffré avant de partir
Chaque objet est chiffré côté client avec age, pour vos clés. Le bucket ne voit jamais de texte clair, et la clé de catalogue de la console ne peut pas lire les données.
Compressé par défaut
zstd au niveau choisi par politique, appliqué une seule fois dans le pipeline. Les outils de dump travaillent sans compression et le serveur de base ne dépense aucun CPU pour cela.
Ne se bloque jamais
Pas de montage ni de périphérique bloc ; les bases uniquement par le réseau. Chaque flux a un chien de garde de progression, chaque outil tourne dans son propre groupe de processus.
Crash-only
Tuez n'importe quel pod à tout moment. Une sauvegarde n'existe qu'une fois son manifeste écrit en dernier, et la suite de chaos tue Keeper en pleine sauvegarde pour le prouver.
Doux avec la production
Utilisateurs en lecture seule au moindre privilège. Créneaux par hôte, limites de bande passante et un garde de charge qui reporte la sauvegarde si le serveur est occupé.
Console, CLI et API
Une API JSON décrite en OpenAPI, avec des rôles issus de Cloudflare Access. Chaque écriture et chaque requête sont auditées.
Natif GitOps
Stores, politiques, cibles et restaurations sont des CRD. Paliers de rétention, alertes et tableau de bord Grafana sont livrés avec le chart.
Les données passent par des Jobs, jamais par le contrôleur.
Le contrôleur ne fait que planifier. Movers et streamers transportent les octets dans un seul pipeline en flux jusqu'à votre bucket, et le restorer les ramène.
Bien plus qu'un dump nocturne dans un bucket.
| Quand vous devez… | script cron + pg_dump | Keeper |
|---|---|---|
| Revenir à 09:41:27 | Le dump d'hier soir, jusqu'à 24 h perdues | N'importe quelle seconde de la fenêtre |
| Prouver qu'une sauvegarde se restaure | Le découvrir pendant l'incident | Restaurations de vérification planifiées avec vos contrôles |
| Trouver la version avec les lignes perdues | En restaurer plusieurs et regarder | Diffs et résumés de modifications dans la console |
| Regarder sans risque | Restaurer sur un staging partagé | Un bac à sable privé avec TTL |
| Garder le bucket aveugle | Chiffrement côté serveur, s'il est configuré | Chiffrement age côté client, avec vos clés |
| Survivre à un nœud qui tombe en pleine sauvegarde | Un fichier à moitié écrit qui semble complet | Rien ne compte avant l'écriture finale du manifeste |
| Savoir que tout fonctionne encore | Le silence | Alertes pour sauvegardes en retard, chaînes rompues et retard |
De zéro à restaurable.
Installez le chart
Les CRD, le contrôleur, l'API et la console, le RBAC, les alertes et le tableau de bord.
helm install keeper charts/keeper -n keeper-system --create-namespace \
  --set image.repository=registry.example.com/keeper/keeper --set image.tag=v0.1.0 \
  --set 'targetNamespaces={team-a}'
Indiquez un bucket et vos clés
N'importe quel stockage compatible S3. Générez une clé age avec age-keygen et gardez-en une copie hors ligne.
apiVersion: keeper.republic.global/v1alpha1
kind: BackupStore
metadata: { name: main }
spec:
  s3:
    endpoint: https://s3.example.com
    region: us-east-1
    bucket: db-backups
    credentialsSecret: { namespace: keeper-system, name: keeper-s3 }
  encryption:
    ageRecipients: [age1…]   # clé publique uniquement ; la clé privée reste hors ligne
Déclarez une cible à côté de la base
Créez les utilisateurs en lecture seule avec le SQL de docs/sql/, puis commitez la cible dans git.
apiVersion: keeper.republic.global/v1alpha1
kind: BackupTarget
metadata: { name: app, namespace: team-a }
spec:
  engine: postgres
  endpoint: { host: postgres, port: 5432 }
  databases: [app]
  policy: prod             # complète chaque nuit, fenêtre de 7 jours
  credentials:
    secretRef: { name: keeper-backup-postgres }
    replicationSecretRef: { name: keeper-repl-postgres }
Restaurez quelque chose, exprès
La première sauvegarde complète démarre toute seule. Essayez ensuite ce dont vous espérez ne jamais avoir besoin.
keeper targets
keeper restore team-a/app --at 2026-10-07T09:41:27Z --wait
keeper query <sandbox> -e "select count(*) from orders"
Le guide complet, chaque champ des CRD et l'API REST sont dans la documentation (en anglais).